Один агент или рой
Этот блок про то, когда несколько агентов лучше одного, сколько они стоят и насколько можно доверять опубликованным числам.
Команда Northwind хочет разбить агента поддержки на агента возвратов, агента замены и агента доставки, которые работают над каждым обращением одновременно. У операционного отдела просьба другая: сравнить штрафы за опоздание в 14 договорах с перевозчиками. Оба случая называют multi-agent, а работа совсем разная.
Три архива и один покупатель
У вашего коллеги на телефоне появились помощники. Отправьте троих в три архива, и каждый принесёт по странице. То, что нашёл один, не меняет того, что искать другому, поэтому разговаривать им незачем.
Теперь посадите двух помощников на два телефона с одним покупателем. Один обещает возврат, другой обещает замену, и друг друга они не слышали.
По определению Anthropic, мультиагентная система — это несколько экземпляров модели с отдельными разговорами, которые координирует код. Словом «рой» (swarm) это называют вольно, хотя у Anthropic рой значится одним из нескольких паттернов. Простая форма, которую берём здесь: ведущий агент, или оркестратор, раздаёт работу субагентам.
Распараллеливание по шагам
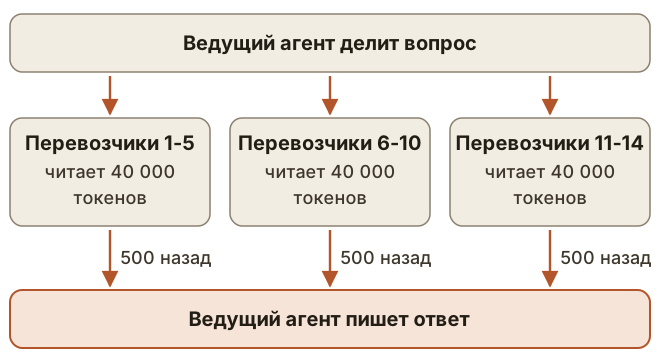
- Ведущий агент читает запрос и пишет задание каждому субагенту. В исследовательской системе Anthropic короткие задания приводили к повторным поискам и неверно понятым задачам.
- Ваш код запускает субагентов параллельно, у каждого свой контекст.
- Каждый субагент крутит собственный цикл и сжимает найденное.
- Ведущий агент читает короткие отчёты и пишет ответ.
Задание для работы с договорами:
{
  "objective": "Find late-delivery penalty terms for carriers 1 to 5",
  "output": {
    "carrier": "string",
    "penalty_cents_per_day": "number or null",
    "clause": "string"
  },
  "tools": [
    "read_contract",
    "search_tickets"
  ],
  "out_of_scope": "Carriers 6 to 14. Do not contact any carrier."
}
Оба инструмента только читают, поэтому субагенты не могут изменить то, на что опирается другой. Повторить работу или разойтись в выводах они всё равно могут, поэтому ведущий агент проверяет то, что получил.
Когда работа пишет
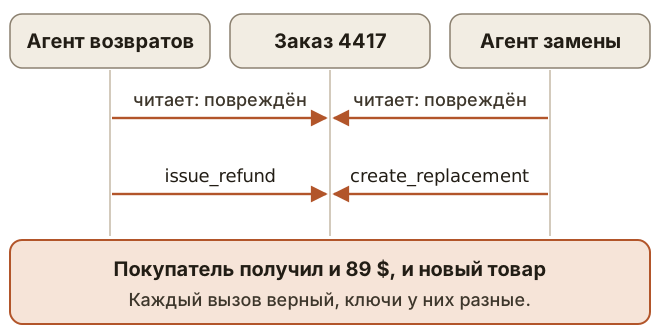
Cognition описала этот сбой в июне 2025 года двумя принципами: агентам нужен полный контекст друг друга, а действия несут неявные решения, которые могут конфликтовать. Ключи идемпотентности здесь не помогут, потому что возврат и замена — это две разные операции.
Заказ — это состояние, и каждый шаг зависит от предыдущего, поэтому владеть им должен один агент. В январе 2026 года Anthropic посоветовала то же: работа с общим состоянием остаётся вместе, а делить нужно по контексту, а не по ролям. В одном из её экспериментов агенты, разделённые на планировщика, исполнителя, тестировщика и ревьюера, тратили на координацию больше токенов, чем на работу.
В апреле 2026 года Cognition сообщила о мультиагентных схемах, которые работают у её агентов для кода, с более узким правилом: запись остаётся в одном потоке (writes stay single-threaded). Дополнительные агенты советуют или проверяют.
Два числа, две базы
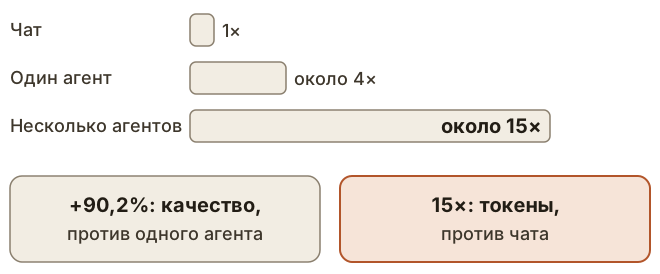
Система Research от Anthropic с ведущим агентом на Opus 4 и субагентами на Sonnet 4 обошла одного агента на Opus 4 на 90,2% во внутренней исследовательской оценке. Отдельно: её агенты обычно тратили примерно в 4 раза больше токенов, чем чат, а мультиагентные системы примерно в 15 раз.
Поэтому «в 15 раз дороже одного агента» — неверно. Деление двух соотношений даёт примерно 3,75 раза относительно одного агента, и это наша арифметика на округлённых числах. В статье Anthropic 2026 года сказано, что в её тестах на равноценных задачах разница составляет от 3 до 10 раз.
90,2% получены во внутренней оценке вендора, Anthropic пишет, что такие системы особенно сильны на запросах вширь, а в посте не сказано, что одиночный агент получал тот же бюджет. Anthropic пишет, что такие системы работают главным образом потому, что помогают потратить достаточно токенов. На BrowseComp, тесте на поиск труднодоступных сведений в вебе, один только расход токенов объяснял 80% разброса результатов. Выигрыш может давать архитектура, траты или и то и другое.
На скорость тоже не рассчитывайте. Параллельные субагенты заканчивают раньше последовательных, но Anthropic пишет, что мультиагентные системы часто работают дольше одного агента.
При контроле бюджетов
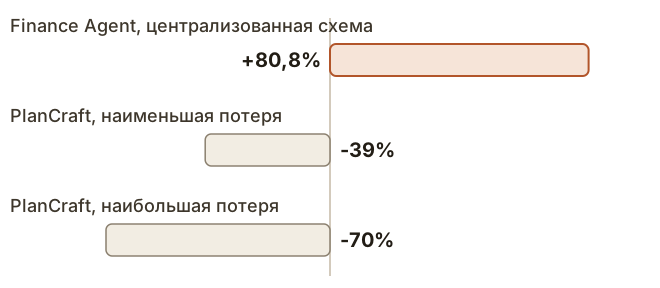
Контролируемое исследование 260 конфигураций на шести бенчмарках показало, что знак зависит от задачи. На PlanCraft, бенчмарке на планирование, трассы показали, что короткую последовательную работу делегировали без всякой пользы. Авторы вывели и правило выбора: выше примерно 45% успеха одного агента оно предсказывает нулевой или отрицательный выигрыш от новых агентов.
Источник | Условия | Результат | Ограничения |
|---|---|---|---|
Anthropic, 2025 | Внутренняя исследовательская оценка | +90,2% против одного агента | Оценка не опубликована, равенство бюджетов не заявлено |
Исследование масштабирования, 2025-26 | Шесть бенчмарков без пользователя, равные вычисления | От +80,8% до -70% | Порог в 45% успеха одного агента — правило выбора, а не универсальная граница |
Исследование dual-control, октябрь 2026 | Около 7950 смоделированных чатов поддержки по письменной политике | Взвешенное среднее -28 пунктов по 12 ячейкам (95% ДИ от -44 до -12) | Препринт, смоделированные пользователи, одна схема, планировщик которой не видел схем инструментов |
MAST, 2025 | 7 фреймворков с открытым кодом | От 41% до 86,7% прогонов провалились | В этом числе нет сравнения с одним агентом |
Третья строка ближе всего к Northwind. Смоделированный покупатель сообщает сведения реплика за репликой, а в одном из трёх доменов может и действовать сам: это и называется dual-control. Ячейка — это одна модель на одном домене. Централизованная мультиагентная система оказалась хуже в 12 из 13 ячеек, прошедших проверки валидности, в оставшейся сыграла вничью и заметно не снизила число ошибочных записей в базу. Проиграла она и на двух ячейках явно ниже 45%, где правило предсказывает выигрыш. Та ячейка, что сыграла вничью, выиграла 10 пунктов только с другим смоделированным покупателем.
Бюджеты там не были равными: потолок мультиагентной системы был в 4 раза выше 75-го перцентиля токенов вывода одного агента. Без потолка, на трёх проверенных ячейках, она в лучшем случае догоняла одного агента при расходе в 5,5 раза выше его медианы.
И выигрыш вендора, и проигрыш на бенчмарке описывают конкретные схемы на конкретных задачах. Ни то ни другое не скажет, что будет на ваших обращениях.
Как решать
Anthropic рассказывает о командах, которые месяцами строили мультиагентные архитектуры, а потом получали тот же результат, улучшив промпт одного агента. Так что начинайте с одного.
Добавляйте субагентов для независимого чтения, для работы, которая не влезает в один контекст, или для узкой задачи на чтение, которая забила бы основной контекст. Запись в общее состояние, например в заказ, держите в одном потоке. Потом проверьте обе схемы на своих задачах при одинаковом бюджете токенов и сравните цену одного решённого обращения.
У Northwind сравнение договоров можно распараллелить. Обращение остаётся у одного агента.
Вывод
- Распараллеливайте независимое чтение. Работу с состоянием, например заказ, оставляйте одному писателю.
- +90,2% посчитаны против одного агента, а 15× против чата, поэтому не сводите их в одно утверждение.
- При контроле бюджетов результаты идут от большого выигрыша до большого проигрыша, в зависимости от задачи.
- Сравнивайте обе схемы на своих задачах при одинаковом бюджете.