Почему растёт счёт за агента
В этом блоке посчитаем, почему счёт за входные токены растёт быстрее числа шагов, что меняет кэширование промпта и что незаметно его выключает. Цены взяты со страниц провайдеров 2026-11-10. Меняются они часто, поэтому считайте их примерами для расчёта.
Спорный возврат в Northwind Goods занимает у агента поддержки 20 вызовов модели, обычное обращение — 10. В финансах ждали, что спорный случай обойдётся вдвое дороже. Он обходится больше чем втрое.
Снова зачитать записи
Вернёмся к коллеге на телефоне, который забывает всё, как только вы кладёте трубку. Перезванивая, вы каждый раз зачитываете весь разговор с начала и платите за каждое прочитанное слово. Первое чтение короткое. Двадцатое длинное, и большую часть слов в нём вы уже оплачивали.
Возьмём три числа из этого прогона:
- Каждый вызов начинается с 6 000 токенов: системный промпт, схемы инструментов, сообщение покупателя.
- Каждый шаг добавляет 1 500 токенов: 300 написала модель и 1 200 пришло из результата инструмента.
- Ваш код отправляет всё это заново при каждом вызове.
Получается, вызов 1 отправляет 6 000, вызов 2 — 7 500, а вызов 20 — 34 500.
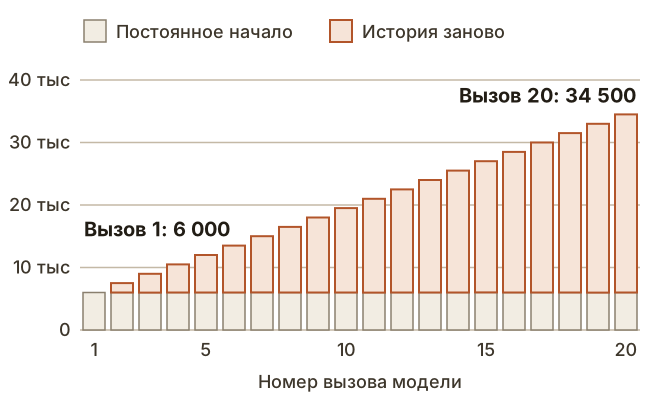
Если сложить столбики, получится формула, где n — число вызовов, P — токены в начале, d — токены, добавленные за шаг:
всего на входе = n * P + d * n * (n - 1) / 2Вызовов | Всего входных токенов |
|---|---|
10 | 127 500 |
20 | 405 000 |
40 | 1 410 000 |
При переходе от 20 вызовов к 40 вход вырастает в 3,5 раза. Первое слагаемое растёт вместе с n, второе — с квадратом n. В коротких прогонах первое заслоняет второе, поэтому на быстром тесте всё выглядит безобидно.
На Claude Sonnet 5.5 миллион входных токенов стоит $2, выходных — $10. Прогон из 20 вызовов тратит $0,81 на вход и $0,06 на выход, то есть вход составляет 93% счёта.
Копия на столе
Допустим, коллега снимает копию того, что вы прочитали, и держит её на столе пять минут. Вы всё равно читаете с самого начала. Пока ваши слова совпадают с копией, он просто ведёт по ней пальцем, а это быстро и дёшево. На первом же несовпавшем слове копия перестаёт помогать, и дальше он слушает как обычно.
Это и есть кэширование промпта. Провайдер хранит результат обработки начала промпта, то есть префикса. В API вроде Anthropic всю историю вы всё равно отправляете при каждом вызове, и вся она по-прежнему остаётся контекстом модели. Дешевле становится только совпавшая часть.
В Messages API от Anthropic кэширование включаете вы сами. Ваш код добавляет одно поле:
{
  "model": "claude-sonnet-5-5",
  "max_tokens": 1024,
  "cache_control": {
    "type": "ephemeral"
  },
  "system": "You are the Northwind support agent...",
  "messages": []
}
Что происходит от вызова к вызову при такой настройке:
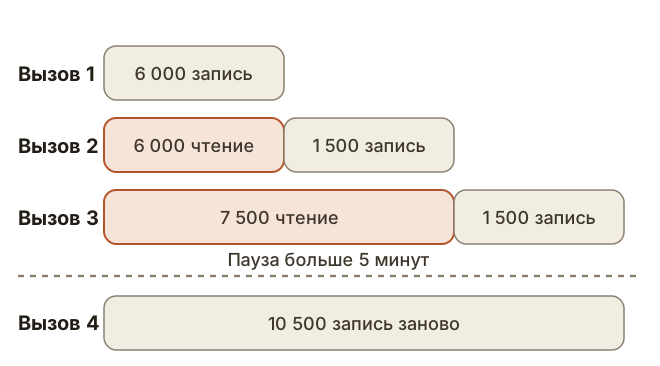
Вызов 1. API ничего не находит, обрабатывает промпт и сохраняет его. Это запись, она стоит в 1,25 раза дороже обычного входа при стандартном сроке в 5 минут.
Вызов 2. API находит тот же префикс и читает его. На Sonnet 5.5 чтение стоит 0,05 от цены входа. Блок, добавленный после вызова 1, записывается.
Каждое чтение бесплатно продлевает эти 5 минут. Отсчёт идёт с начала запроса, поэтому долгий ответ тоже расходует это время. Если прогон остановится дольше, следующий вызов запишет всё заново.
Вызов 20 сообщает об этом в usage:
{
  "usage": {
    "input_tokens": 0,
    "cache_read_input_tokens": 33000,
    "cache_creation_input_tokens": 1500,
    "output_tokens": 300
  }
}
Весь вход — это сумма первых трёх полей. В API Anthropic input_tokens считает только то, что идёт после последней точки кэширования, поэтому дашборд, который смотрит лишь на это поле, покажет почти ноль.
Вызовов | Запись | Чтение | Выход | Итого | Без кэша |
|---|---|---|---|---|---|
20 | $0,09 | $0,04 | $0,06 | $0,18 | $0,87 |
50 | $0,20 | $0,21 | $0,15 | $0,55 | $4,43 |
100 | $0,39 | $0,79 | $0,30 | $1,47 | $16,35 |
Каждое число округлено до цента, поэтому строка может расходиться со своей суммой на цент.
Посмотрите на столбец «Чтение». Кэш снижает цену токена, а форму роста не трогает: чтение по-прежнему растёт с квадратом n. К 100 вызовам на него приходится больше половины счёта. На выход скидки нет вообще.
Что ломает совпадение
Сравнение идёт от начала промпта и не может пройти дальше первого различия. В API Anthropic для чтения нужна ещё и запись в кэше, которую более ранний запрос сделал в точке кэширования. Порядок такой: tools, потом system, потом messages, и изменение на одном уровне сбрасывает этот уровень и все следующие.
 system:
-  Current time: 2026-11-10T14:03:22Z. You are the Northwind support agent...
+  You are the Northwind support agent...
 messages:
   ...earlier steps...
+  Current time: 2026-11-10T14:03:22Z
Поэтому всё неизменное идёт первым, а всё меняющееся — последним.
В API Anthropic здесь нужен ещё один шаг. cache_control на верхнем уровне запроса ставит точку кэширования на последний блок, а при такой раскладке этот блок меняется при каждом вызове, и читать будет нечего. Поставьте cache_control на последний блок, который не меняется, как советует документация. Время тогда попадёт в input_tokens.
Что случилось | Что теряется в API Anthropic |
|---|---|
Время или id запроса в начале промпта | Если точка кэширования одна и в конце, всё чтение при каждом вызове |
Инструмент добавили, убрали или переписали | Весь кэш |
Поправили фразу в системном промпте | System и messages |
Поменяли | Messages |
Пауза дольше 5 минут, например ожидание подтверждения от человека | Всё. Есть срок в 1 час, но запись тогда стоит вдвое дороже обычного входа |
Промпт короче минимума модели, на Sonnet 5.5 это 512 токенов | Ошибки нет. Оба поля кэша в |
В руководстве OpenAI про инструменты тот же совет: не менять определения, порядок и схемы.
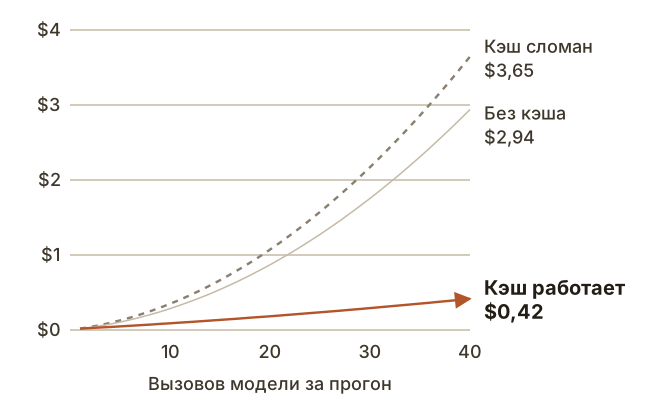
Сломанный кэш хуже, чем никакого. Если время новое при каждом вызове, из кэша не читается ничего, а каждый токен оплачивается по цене записи.
У провайдеров по-разному
Проверено 2026-11-10:
| Как включается | Запись | Чтение |
|---|---|---|---|
Anthropic Messages API | Вы добавляете | 1,25x на 5 минут, 2x на 1 час | 0,1x; 0,05x на Opus 5.5 и Sonnet 5.5; 0,025x на Fable 5.1 и 5.2 |
OpenAI, GPT-5.6 и новее | По умолчанию | 1,25x на 30 минут, 2,5x на 12 часов в Responses API | 0,1x; 0,05x на GPT-6.1 Sol и Terra |
У старых моделей OpenAI другие правила, а Gemini 2.5 и новее кэшируют неявно и по умолчанию. Прежде чем строить на этом оценку, посмотрите страницу цен своей модели.
Вывод
- Каждый вызов заново отправляет историю, поэтому весь вход растёт примерно с квадратом числа вызовов.
- Кэш сильно удешевляет совпавший префикс. Чтение всё равно растёт с квадратом, а на выход скидки нет.
- Неизменное ставьте в начало, меняющееся в конец и проверяйте поля кэша в
usage.