Reflexion
Этот блок про то, как агент может использовать неудачную попытку, чтобы следующая прошла лучше, и когда за это стоит платить.
Агенту поддержки Northwind нужно, чтобы track_order работал с новым перевозчиком, поэтому фоновый агент пишет парсер, который переводит события перевозчика в статусы Northwind. У Northwind есть 40 настоящих событий, размеченных вручную. Первая попытка верно разбирает 37. Второй прогон с тем же промптом ошибается на тех же 3.
Записка в кармане
Представьте ученика на закрытом автодроме. Он заваливает заезд на втором перекрёстке, а экзаменатор говорит только «не сдал». Если поехать снова, ничего не поменяв, скорее всего, он ошибётся там же. Поэтому перед новым заездом ученик пишет себе записку: «На втором перекрёстке сначала смотреть в правый ряд». Площадку освобождают, он снова стартует от ворот, а записка едет с ним.
Reflexion, метод из статьи 2023 года, проделывает это с агентом. Ему нужны площадка, которую можно очистить, экзаменатор и карман для записок.
Почему тот же промпт снова проваливается
В статье базовые агенты на HotPotQA (вопросы в несколько шагов) при повторах с температурой 0.7 не решили ни одной задачи, проваленной с первого раза. На AlfWorld (бытовые задачи в текстовом мире) обычные повторы какое-то время давали прирост, но между 6-й и 7-й попытками он прекратился.
Retry подходит для сбоев, которые проходят сами, как в блоке об остановке. Неверный подход сам не пройдёт.
Один круг по шагам
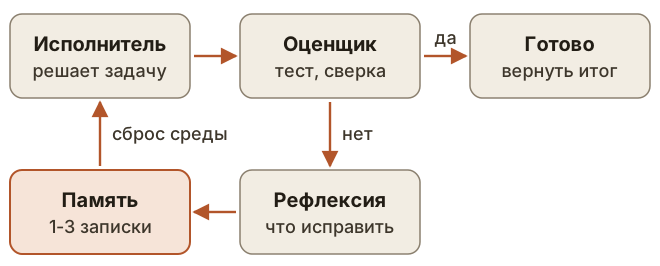
- Исполнитель, ваш обычный цикл агента, проходит всю задачу в свежей среде. Цепочка его шагов и наблюдений называется траекторией.
- Оценщик оценивает траекторию. В статье это была точная сверка на HotPotQA, написанные самим агентом юнит-тесты для кода, а на AlfWorld либо языковая модель, либо написанное вручную правило (одно и то же действие и один и тот же ответ больше 3 циклов или больше 30 действий). В некоторых из этих вариантов модель вообще не участвует.
- Если проверка пройдена, ваш код останавливается.
- Если нет, модель рефлексии получает траекторию, сигнал оценщика и прежние записки. Она пишет, что пошло не так и что сделать иначе.
- Ваш код сохраняет записку и оставляет только несколько последних. В статье предел обычно составлял от 1 до 3, потому что записки должны помещаться в контекст.
- Ваш код сбрасывает среду, и исполнитель начинает заново с записками в промпте.
После первой неудачи запись о парсере у Northwind выглядит так:
{
  "trial": 1,
  "evaluator": {
    "passed": false,
    "failed_fixtures": [
      "evt_12",
      "evt_29",
      "evt_33"
    ],
    "example": {
      "event": "DELIVERY_ATTEMPT_FAILED",
      "expected": "in_transit",
      "got": "delivered"
    }
  },
  "note": "I treated any status containing DELIVER as delivered. Match full status codes. DELIVERY_ATTEMPT_FAILED means in_transit."
}
Весь цикл короткий:
def reflexion(task, max_trials=4, keep_notes=3):
    notes = []
    for trial in range(1, max_trials + 1):
        env = reset_environment(task)
        trajectory = run_actor(task, notes, env)      # полный прогон агента
        verdict = run_fixtures(env)                   # обычный код, без модели
        if verdict["passed"]:
            return {"status": "passed", "trials": trial, "result": trajectory}
        note = reflect(task, trajectory, verdict, notes)  # один вызов модели
        notes = (notes + [note])[-keep_notes:]
    return {"status": "gave_up", "trials": max_trials}
В статье записка идёт в следующую попытку той же задачи. «Сверяй коды статусов целиком» помогает этому парсеру, а в работу следующей недели здесь ничто её не перенесёт.
Три похожих цикла
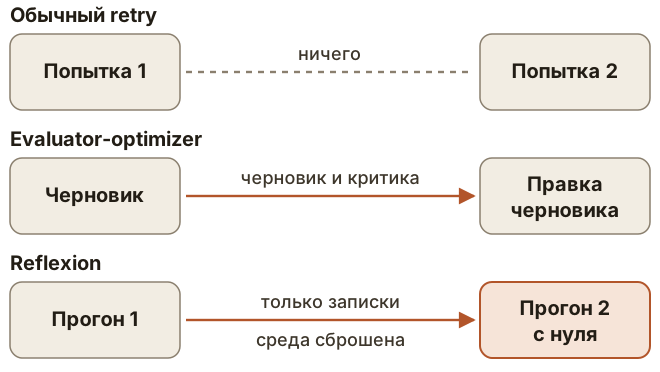
Evaluator-optimizer из блока о workflow критикует один черновик и правит его. В прогонах статьи на AlfWorld Reflexion выбрасывает попытку, сбрасывает среду и переносит только текст. Агент для кода из той же статьи — исключение: следующая попытка видит ещё и прежний код с результатами тестов, так что для кода граница между двумя циклами тонкая. Цикл Northwind выше переносит только записки.
В посте LangChain от февраля 2024 года есть учебный пример под названием Reflexion: он пишет черновик ответа, ищет подтверждения и правит тот же ответ. В самом посте сказано, что он идёт по одной фиксированной траектории. Это может быть полезно, но сброса между попытками там нет.
Сколько это стоит
Каждый круг — это полный прогон, оценка и, после неудачи, один вызов рефлексии. Две неудачи и успех стоят трёх прогонов и двух рефлексий, плюс три оценки, если ваш оценщик вызывает модель. Каждый шаг добавляет время, поэтому для ответов с низкой задержкой метод подходит плохо.
Потолок задаёт экзаменатор
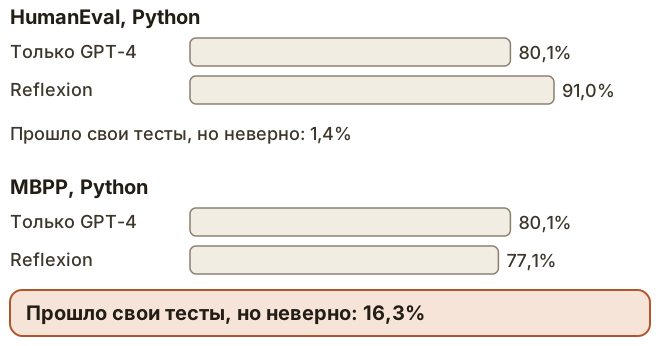
HumanEval и MBPP — это наборы коротких задач на программирование. Авторы статьи объясняют проигрыш на MBPP ложными срабатываниями тестов. Когда тесты проходят на неверном коде, цикл останавливается и сообщает неверный ответ. Та же беда у любого оценщика, который может одобрить плохую работу, в том числе у второй модели, оценивающей что-то столь расплывчатое, как тон.
Чтобы понять, что даёт каждая часть метода, её отключают. Такой эксперимент на 50 самых сложных задачах HumanEval на Rust с GPT-4 говорит о том, что важны обе половины. Pass@1 — это доля задач, где решение, которое система отправила, проходит тесты самого бенчмарка:
Настройка | Pass@1 |
|---|---|
Базовая модель | 60% |
Записки без тестов | 52% |
Тесты без записок | 60% |
Тесты и записки | 68% |
Разница между 60% и 68% — это 4 задачи из 50. Строку с 52% авторы объясняют так: без тестов агент не мог понять, верен ли его код, поэтому продолжал работу и вносил вредные правки.
Reflexion не сработал ещё в двух местах. На WebShop, бенчмарке с заданиями в интернет-магазине, где нужен разнообразный поиск, авторы остановились после четырёх попыток: агент не показывал улучшения. На HumanEval для Python с небольшой моделью starchat-beta он набрал 26%, столько же, сколько базовый вариант. Это результаты на моделях и бенчмарках 2023 года, так что измеряйте на своих задачах.
Нет сброса — нет Reflexion
Неудачный заезд на автодроме никому не вредит. issue_refund на настоящем заказе — это уже дорога общего пользования: деньги ушли, и вторая попытка может отправить их снова. Запускайте попытки только в песочнице или на копии данных. Для сгенерированного кода авторы тоже советуют изолированные среды.
Вывод
- Когда неверен сам подход, тот же промпт обычно повторяет ошибку. Reflexion добавляет записку о том, что изменить.
- Нужны среда, которую можно сбросить, и оценщик, которому можно верить. Ложные срабатывания ограничивают выигрыш.
- Каждая попытка — это полный прогон, поэтому метод подходит для офлайн-работы вроде кода с тестами. Живым ответам и необратимым действиям он не подходит.