Сказал «готово», а ничего не произошло
Этот блок объясняет, почему «готово» от агента ничего не доказывает, как система узнаёт, что произошло на самом деле, и как измерить разницу.
Агент Northwind пишет покупателю: «Ваш возврат на $38.00 по заказу 4417 оформлен». Через пять дней покупатель сообщает, что деньги не пришли. В платёжных записях возврата по этому заказу нет, а прогон записан как успешный.
Коллега и выписка
Вернёмся к коллеге на телефоне. Он говорит: «Всё оплачено». У этой оплаты теперь три свидетеля. Слова коллеги. Клерк банка, который сказал по телефону «хорошо». И строка в банковской выписке.
Факт здесь только выписка. Коллега мог описать то, что собирался сделать. Клерк мог сказать «хорошо» про перевод, который так и не прошёл.
Последнее сообщение прогона — это слова коллеги. Ложный успех (false success) — так называют заявление о завершении, которое фактическое состояние не подтверждает.
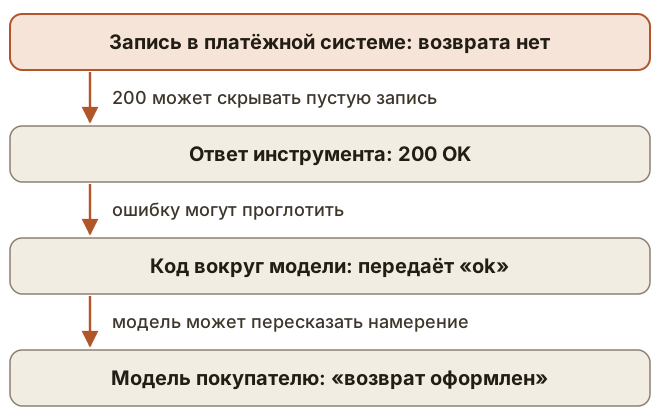
Обычно ломается одно из трёх, по одному на каждом шаге:
Инструмент сообщает неправду. Сервис отвечает 200, хотя ничего не записано или запись неполная. После изменения интеграции так могут возвращаться все вызовы.
Код вокруг модели прячет ошибку. Эта обёртка превращает любой сбой в хорошую новость:
try:
    payments.refund(order_id, amount, idempotency_key=key)
except Exception:
    log.warning("refund failed")
return "Refund submitted."
Модель пересказывает намерение. Она попросила возврат или только собиралась и поэтому пишет, что возврат состоялся, даже если в результате был pending или ошибка. Никакая уверенность этой фразы не скажет, что из двух произошло.
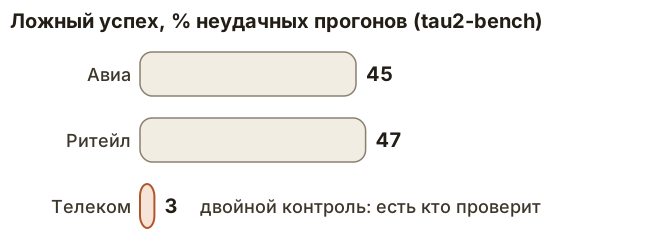
Как часто? В одной работе с воркшопа 2026 года, у которой один автор, разобрано 9876 прогонов 8 семейств моделей на бенчмарке поддержки tau2-bench. Доля неудачных прогонов, где агент всё равно заявил о завершении, оказалась такой:
Читаем выписку
Сначала инструмент записи возвращает поля, которыми может пользоваться код, а не фразу:
{
  "status": "succeeded",
  "refund_id": "re_31",
  "order_id": "4417",
  "amount_cents": 3800
}
Эти поля тоже могут быть неверны, как показал 200 выше. Поэтому после записи ваш код читает сохранённые данные и сравнивает их с тем, что просил. Проверка, которая работает вне модели и решает, каков итог, называется верификатором.
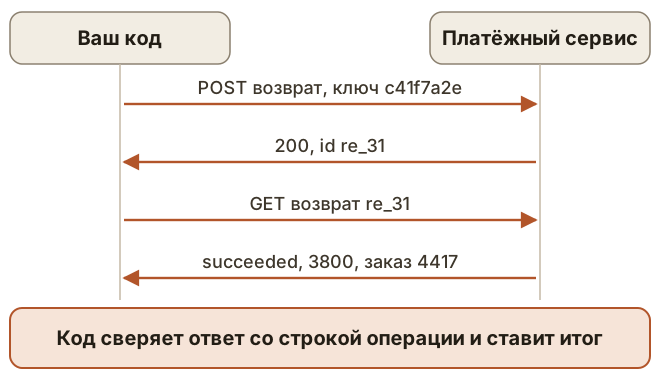
def verify_refund(op):
    if op.refund_id is None:
        return "unknown"    # no confirmed reply, so the refund may still exist
    try:
        refund = payments.get_refund(op.refund_id)
    except (Timeout, ServiceError):
        return "unknown"
    if refund.amount != op.amount_cents or refund.metadata["order_id"] != op.order_id:
        return "not_landed"
    return {"succeeded": "landed", "pending": "pending", "requires_action": "pending"}.get(refund.status, "not_landed")
Сорвавшаяся проверка — это третий ответ. Если чтение зависло по таймауту, вы не знаете итога, а что делать в таком случае, разобрано в прошлом блоке.
Итог определяет, что прочтёт покупатель:
Итог | Что сообщают покупателю |
|---|---|
| Возврат выполнен, с суммой |
| Возврат в пути |
| Коллега проверяет |
| Не прошло, делом занимается человек |
Одно чтение показывает один момент времени. В Stripe статус возврата может быть pending, requires_action, succeeded, failed или canceled, и в редких случаях возврат переходит в failed, потому что банк покупателя не смог его обработать. Тогда Stripe присылает событие refund.failed, поэтому на вашей стороне кто-то должен его слушать.
У проверки есть цена: лишнее чтение и лишняя задержка на каждую запись. Для денег и прав платите её всегда, остальное проверяйте выборочно.
Считаем разрыв
Каждый прогон даёт два отдельных факта: что сказал агент и что нашла проверка.
{
  "run_id": "run_9312",
  "order_id": "4417",
  "claimed": "done",
  "effect": "not_landed"
}
Просите агента в конце прогона дать заявление в структурированном виде, чтобы не разбирать фразы. Затем считайте оба показателя на одних и тех же прогонах. Вот неделя в Northwind:
Показатель | Прогонов |
|---|---|
Агент заявил «готово» | 4120 |
Заявил «готово», и проверка прошла | 3950 |
Ложный успех | 170 (4,1% заявлений) |
Самоотчёт агента всю неделю выглядел бы здоровым, как и график доступности. Алерт настройте на эти 170. Прогон, который всё ещё pending, учитывается, только когда итог определится.
Почему не спросить другую модель
Напрашивается LLM-судья, который прочитает переписку и решит. В той же работе ни одна конфигурация судьи не превысила AUROC 0,65 на tau2-bench, где 0,5 — это подброшенная монета, а 1 — идеал. Автор объясняет это тем, что судьи опираются на уверенные завершающие фразы, а их в прогонах с ложным успехом хватает. Для первичного отбора прогонов работа предлагает лёгкие обученные детекторы.
Руководство Anthropic по оценке агентов проводит ту же границу в общем виде. Transcript — это запись прогона, где видно, что агент сказал и сделал, а outcome — конечное состояние среды. В его примере оценки поддержки возврат проверяется по состоянию, а тон — LLM-рубрикой. Модели оставьте оценку тона. Запись пусть читает код.
Вывод
- Последнее сообщение — это заявление, а
200всего лишь заявление посильнее. - После записи код читает сохранённые данные, сравнивает и ставит итог. «Не удалось проверить» — отдельный результат.
- Считайте заявления и проверенные итоги на одних прогонах и настройте алерт на разницу.